
TryCatch.tv
Judlup
0
TryCatch.tv es un podcast en español dedicado al desarrollo de software y la tecnología, conducido por Judlup. Bajo el lema «aprender haciendo», el programa se centra en aprender programación y herramientas técnicas a través de la práctica y de proyectos reales. También trata temas de la comunidad de AWS, donde el anfitrión participa como AWS Community Builder. Está dirigido a desarrolladores hispanohablantes interesados en la nube, el código y el crecimiento profesional.
Episoder
-
 La IA creó, reparó y mantuvo software sin escribir código tradicional 16.10.2026 1t 31min¿Podemos construir y mantener software con agentes de IA sin generar código fuente tradicional?Lo pusimos a prueba con un enfoque Agent-Native Development, utilizando una representación semántica en JSON (Semantic IR) que un agente puede generar, reparar y modificar, y una herramienta determinista desarrollada en Rust para verificarla y compilarla directamente a WebAssembly.Durante la transmisión construimos cuatro experimentos: generación desde cero, reparación de errores, extensión de funcionalidades y mantenimiento de reglas de negocio. Los cuatro cumplieron sus criterios de éxito, incluyendo pruebas funcionales, regresiones y reproducibilidad binaria.Y después llegó una comparación interesante. En un benchmark adicional frente a una implementación equivalente en Rust, nuestra ruta IR → WASM registró 49 veces menos tiempo en el ciclo inicial de verificación y compilación, y produjo un archivo WASM 44,9 % más pequeño, con las mismas pruebas funcionales aprobadas.Estos resultados corresponden a una POC de alcance limitado y no incluyen el tiempo que necesita el agente para generar el programa. Todavía no demuestran una ventaja general frente a los lenguajes tradicionales, pero abren una línea de investigación sobre cómo diseñar representaciones que los agentes puedan construir y evolucionar de manera verificable.El experimento ya no demuestra solamente que funciona: ahora también tenemos una primera evidencia cuantitativa para investigar su rendimiento.
-
 Cómo evolucionaron Agile y Scrum con la IA y Spec-Driven Development 15.10.2026 41min¿Agile realmente está muriendo o simplemente seguimos utilizando Scrum como si desarrollar software no hubiera cambiado en los últimos años?En esta sesión analizamos dos artículos que cuestionan la forma en que organizamos el desarrollo de software: The Death of Agile, Jira, and Confluence y Spec-Driven Development in Scrum and Kanban. A partir de ellos recorremos el origen de Agile, los problemas que buscaba resolver y cómo, en algunos equipos, las ceremonias, los tickets y los tableros terminaron adquiriendo más importancia que el valor que deberían generar.También discutimos cómo cambia el desarrollo cuando incorporamos agentes de IA. Si ahora podemos producir código mucho más rápido, necesitamos prestar más atención a la claridad de los requisitos, el contexto, las decisiones y la verificación. Ahí aparece Spec-Driven Development, no como un reemplazo obligatorio de Scrum o Kanban, sino como una manera de integrar especificaciones vivas dentro de sus ciclos de trabajo.Finalmente revisamos los niveles de especificación, por qué no todas las tareas necesitan el mismo contexto y cómo medir si realmente estamos mejorando mediante tiempos de entrega, retrabajo y aprendizaje continuo.La conclusión no es que Scrum esté muerto ni que Jira haya dejado de servir. El desafío es recuperar los principios ágiles y adaptar nuestras prácticas a una realidad en la que personas y agentes participan en la construcción de software.
-
 De POC a MVP: Pathfinder ya tiene IA, AWS Events y un journey completo 14.10.2026 50minPathfinder comenzó como una idea para resolver un problema de AWS re:Invent: entre miles de sesiones, ¿cómo identificar cuáles realmente nos ayudan a aprender lo que necesitamos para nuestros proyectos?En esta sesión revisamos cómo evolucionó re Pathfinder hasta su versión v0.22.0, las decisiones que tomamos para construir su arquitectura y la integración de inteligencia artificial con Amazon Bedrock. Explicamos por qué no todo necesita resolverse con un LLM, cómo funciona el análisis de brechas de conocimiento, el ranking de sesiones y la separación entre los modos Demo y Live.También recorremos el MVP: desde describir un proyecto y descubrir sus Knowledge Gaps hasta obtener un Learning Path, evaluar las sesiones mediante reflexiones, adaptar las recomendaciones y generar un Learning Report. Además, mostramos el Availability Heatmap para encontrar charlas disponibles y gestionar favoritos y reservas.Finalmente probamos la integración Live con AWS Builder ID y revisamos algunas limitaciones que todavía deben validarse, especialmente la disponibilidad del catálogo y el procesamiento real con Bedrock. Cerramos mostrando cómo quedó organizado el proyecto, su arquitectura y el trabajo realizado para llegar a esta versión.La idea central es que Pathfinder no busca simplemente recomendar charlas: busca convertir lo que estás construyendo o quieres aprender en una ruta de aprendizaje que evoluciona durante el evento.
-
 re:Invent Pathfinder: Live Event Experience con AWS Events y Builder ID 07.10.2026 46minPathfinder dio un salto importante: dejó de trabajar únicamente con el journey de aprendizaje y empezó a interactuar con el evento real de AWS re:Invent.En esta sesión mostramos el problema que apareció al intentar encontrar disponibilidad entre más de 2.000 sesiones y cómo terminó convirtiéndose en una nueva capacidad de Pathfinder. Probamos el login mediante AWS Builder ID, consumimos información real de AWS Events y construimos una vista que permite identificar rápidamente sesiones disponibles, con disponibilidad limitada o sin cupo, además de consultar agenda y favoritos.Después volvemos al roadmap para cerrar otra parte importante del producto. Replanteamos el alcance de INI-005, separamos la observabilidad relacionada con IA hacia INI-006 y construimos el Learning Report, que compara las brechas iniciales con el conocimiento adquirido durante el evento y genera una ruta posterior con lo que todavía queda pendiente.Finalmente construimos una primera demo pública del proyecto y recorremos Pathfinder de principio a fin: contexto del proyecto, Knowledge Profile, Knowledge Gaps, recomendaciones, Learning Path, reflexión, adaptación, Learning Report y la nueva Live Event Experience.Al terminar la sesión, la base funcional del producto queda prácticamente cerrada y el siguiente gran bloque es claro: reemplazar la inteligencia local/prototipada por la implementación real con servicios de IA en AWS.
-
 re:Invent Pathfinder: construyendo la base del backend y frontend 06.10.2026 1t 5minPathfinder avanzó bastante fuera de transmisión, así que en esta sesión retomamos el proyecto para entender qué estaba realmente construido, qué seguía pendiente y cómo continuar hasta dejar una base sólida de backend y frontend.Primero revisamos las iniciativas y los 11 Work Items ya completados: foundation del monorepo, integración con AWS Events y Builder ID, contratos de Knowledge/AI y las primeras piezas del journey. Al reconciliar el estado descubrimos además inconsistencias entre el código implementado y la evidencia del delivery, por lo que antes de seguir creamos un Work Item específico para corregir esa deuda.Después continuamos con la experiencia de Pathfinder. Levantamos el frontend, recorremos el flujo de contexto del proyecto → perfil de conocimiento → knowledge gaps y construimos el siguiente paso: un Learning Path priorizado y reconciliado con la agenda. Durante la implementación aparece un problema real de compatibilidad entre Node Crypto y el navegador, que corregimos antes de continuar.La sesión termina con la iniciativa 4 completada, 14 Work Items cerrados y una base funcional del API y frontend lista para el siguiente paso: conectar la IA y los servicios reales de AWS para completar el journey end-to-end.00:00 Qué avanzó Pathfinder fuera de transmisión01:30 Estado actual: iniciativas y Work Items02:58 Foundation, AWS Events y autenticación04:14 Knowledge, AI y Learning06:12 11 Work Items y los dos grandes bloques del sistema07:36 Cómo quedó organizado el repositorio08:10 Autenticación con AWS Builder ID09:10 Por qué planear antes aceleró el desarrollo10:04 Qué vamos a construir en esta sesión10:41 Retomando el proyecto y actualizando su estado11:47 Dónde estamos dentro del roadmap12:24 El trabajo offline dejó inconsistencias14:46 Trazabilidad y verificaciones que no cuadraban17:19 ¿Corregir el pasado o crear trabajo nuevo?19:51 Creando un Work Item para reconciliar el proyecto23:05 Refinando la corrección23:50 Implementando el Work Item 1225:39 Corrigiendo evidencia y reconciliando el lifecycle28:07 Entramos a la iniciativa 4: Learning Path29:19 Así está el frontend de Pathfinder30:47 Project Context → Knowledge Profile → Knowledge Gaps31:34 El siguiente paso: Learning Path recomendado33:13 Materializando el Work Item 1335:10 Decisiones de producto antes de implementar37:23 Local-first, human in the loop y defaults del MVP39:40 Implementando el Learning Path42:30 Probando el flujo de autenticación local45:35 Learning Path implementado46:24 Aparece un bug real en el frontend46:46 Node Crypto vs Web Crypto47:42 Verificando el arreglo48:47 Learning Path funcionando en la UI50:56 Ahora toca reflexión y adaptación52:04 Qué hará el Work Item 1453:56 Cómo quedó la topología del sistema55:58 Iniciativa 4 completada56:44 Qué queda para cerrar Pathfinder57:56 Estado final del roadmap01:00:06 Base del API, frontend y flujo end-to-end01:01:20 Qué falta: IA real, UI y despliegue01:02:55 Conclusiones
-
 re:Invent Pathfinder: diseñando los componentes y roadmap del proyecto 03.10.2026 1t 14minPathfinder ya tenía definido el problema y la experiencia que queríamos construir. En esta sesión damos el siguiente paso: descubrir qué componentes necesita realmente el sistema y convertir ese diseño en un roadmap ejecutable.Partimos de las capacidades mínimas del MVP, identificamos qué responsabilidades necesita cada una y construimos progresivamente el mapa de componentes de Pathfinder. Durante el proceso aterrizamos la separación entre cliente, AWS Events, conocimiento, recomendaciones y Adaptive Learning Journey, además de tomar decisiones sobre TypeScript, DynamoDB, Amazon Bedrock, AgentCore, Strands Agents, Serverless Framework y CDK.Con ese contexto llevamos la definición de negocio, producto y tecnología a Kaddo para estructurar el roadmap. El resultado fueron cinco grandes iniciativas: fundación técnica del monorepo, integración con AWS Events API, motor de conocimiento y recomendaciones, experiencia de learning path y reflexión, y cierre del ciclo con la experiencia de demo. A partir de ellas también quedaron identificados 16 candidatos a Work Items.La idea central de la sesión es que antes de pedirle a un agente que escriba código necesitamos entender qué sistema estamos construyendo, qué responsabilidades existen y en qué orden tiene sentido construirlas.
-
 Kiro en el mundo real: cómo se está usando en equipos de software 02.10.2026 1t 11min¿Cómo se ve Kiro cuando deja de ser una herramienta para hacer demos y empieza a utilizarse dentro de equipos, procesos y sistemas reales?En este conversatorio hablamos con profesionales que ya están usando Kiro en escenarios de infraestructura, desarrollo, automatización de despliegues y adopción empresarial. Revisamos cómo trabajan con agentes especializados, steering, skills, MCP, Spec-Driven Development y pipelines, pero también los problemas que aparecen cuando estas prácticas empiezan a escalar.La conversación entra en temas que normalmente no aparecen en una demo: costos por exceso de contexto, resistencia al cambio, sistemas legacy, deuda técnica, confianza en el código generado, gobierno, métricas y ROI. También discutimos cómo cambia el rol del desarrollador cuando escribir código deja de ser el principal cuello de botella.El resultado es una mirada bastante práctica a lo que significa trabajar con IA en el mundo real: menos foco en generar código y más en arquitectura, contexto, validación, orquestación y criterio.
-
 TinyFish: cómo conectar agentes de IA con la web 01.10.2026 1t 2minUn LLM puede razonar sobre información, pero cuando necesita buscar, leer, navegar o interactuar con una página web, necesita herramientas que le permitan salir de su contexto. En esta sesión probamos TinyFish, una plataforma enfocada en darle esas capacidades web a aplicaciones y agentes de IA.Primero entendemos las diferencias entre Search, Fetch, Agent y Browser, cuándo tiene sentido utilizar cada uno y cómo cambia el nivel de autonomía cuando integramos TinyFish mediante MCP. Después hacemos el onboarding desde cero, conectamos TinyFish con un agente y ejecutamos pruebas reales de búsqueda y extracción.La prueba termina siendo especialmente interesante con el sitio de Reebok: Fetch encuentra rápidamente el límite del contenido estático, así que pasamos a un Web Agent para intentar navegar las 18 páginas del outlet. La ejecución tarda cerca de 45 minutos, consume alrededor de 57 pasos y consigue extraer 174 productos únicos, dejando claras tanto las capacidades como las limitaciones y el trade-off entre autonomía, tiempo y costo.La conclusión no es que todo deba resolverse con un Web Agent. Search, Fetch, Agent y Browser tienen costos y niveles de control diferentes; la decisión correcta depende del problema que realmente necesitamos resolver.
-
 Que el agente diga “terminé” ya no es suficiente | Kaddo Lifecycle v2 30.09.2026 44minDar contexto a un agente mejora mucho la calidad de lo que construye, pero aparece otro problema cuando termina: ¿cómo sabemos que realmente hizo lo que le pedimos?En esta sesión recorremos Kaddo Lifecycle v2, la evolución del ciclo de desarrollo de Kaddo para acompañar un cambio desde la intención inicial hasta su verificación. Vemos cómo un Work Item pasa por refinement, planning e Implementation Handoff antes de llegar al agente, y cómo el nivel de contexto se ajusta proporcionalmente al alcance de la tarea.Después de la implementación, el ciclo continúa con Implementation Evidence, Verification, knowledge drift y Learning. La idea es que “terminé” deje de ser suficiente: queremos saber qué cambió, qué validaciones se ejecutaron, si la implementación se desvió del plan y qué nuevo conocimiento debería regresar al proyecto.La idea central es que el desarrollo asistido por IA no debería terminar cuando el agente genera código; debería terminar cuando podemos explicar, verificar y aprender de lo que hizo.
-
 Vamos a construir la aplicación del re:Invent con el Pathfinder 29.09.2026 53minAWS re:Invent tiene cientos de sesiones, workshops y actividades. El problema no es encontrar contenido, sino decidir qué vale la pena ver según lo que estás construyendo y el conocimiento que todavía te hace falta. De ahí nace re:Invent Pathfinder, un proyecto para convertir el catálogo del evento en una ruta de aprendizaje personalizada. re_invent-pathfinder-contexto-d…En esta sesión recorremos el contexto completo del proyecto: cómo detectar knowledge gaps, generar recomendaciones explicables, adaptar la ruta a medida que la persona aprende y organizar la experiencia antes, durante y después del evento. También revisamos la arquitectura propuesta con AWS Events API, API Gateway, Lambda, Amazon Bedrock, CloudWatch y Amplify, evitando agregar infraestructura que todavía no necesitamos. re_invent-pathfinder-contexto-d…Finalmente aterrizamos los milestones de construcción: primero detectar brechas y recomendar sesiones, después incorporar agenda y conflictos, y finalmente construir el ciclo adaptativo que recalcula qué conviene hacer a continuación. El proyecto será open source y se irá construyendo con la comunidad. re_invent-pathfinder-contexto-d… re_invent-pathfinder-contexto-d…La idea central es simple: Pathfinder no busca decirte qué sesiones son populares, sino entender qué estás construyendo para ayudarte a descubrir qué deberías aprender.
-
 IA, agentes y carrera: cómo crecer sin perder el foco 26.09.2026 1t 4minEn esta sesión hablamos de varias cosas que están cambiando la forma en que desarrollamos software: cómo Kaddo está evolucionando y empezando a usarse en proyectos reales, cómo gestionar conocimiento entre sistemas, y qué pasa cuando dejamos de trabajar con un solo agente para empezar a ejecutar varias tareas en paralelo.También hablamos de Git worktrees, de usar modelos diferentes para planeación y ejecución, y de un problema que empieza a hacerse evidente con los agentes: la IA puede construir más rápido de lo que nosotros podemos revisar, entender y cambiar de contexto.La conversación termina llevándonos a carrera y crecimiento profesional: cómo diferenciarse cuando todos están aprendiendo lo mismo, por qué perseguir cada nueva herramienta puede terminar agotándonos, qué pesa cuando queremos pasar de senior a arquitecto, y por qué liderazgo, comunicación, criterio e impacto empiezan a importar más a medida que avanzamos.La idea que atraviesa toda la sesión es sencilla: no se trata de aprender todo lo nuevo que aparece, sino de construir una base sólida y saber hacia dónde queremos crecer.
-
 Cómo desplegar infraestructura en AWS con Terraform | IaC desde cero 24.09.2026 1t 5minEn la sesión anterior definimos la arquitectura de Tryckers. En esta damos el siguiente paso: convertir esas decisiones en infraestructura desplegable y reproducible usando Terraform.Partimos de los servicios que ya habíamos seleccionado para AWS —Amplify, EC2, RDS PostgreSQL, ECR, S3, IAM y SSM— y construimos el flujo completo: definición del Work Item, generación de los archivos .tf, validación, terraform plan, revisión del dimensionamiento y finalmente terraform apply. Durante el ejercicio también usamos Kaddo para mantener trazabilidad entre lo que queríamos construir y los cambios realizados. Al final verificamos directamente en AWS que los recursos fueron creados y encontramos un pendiente real: Amplify quedó aprovisionado, pero todavía falta vincular correctamente el repositorio que deberá desplegar. La idea central de la sesión es sencilla: la arquitectura deja de ser solamente un dibujo cuando podemos reproducirla.
-
 Vibe Coding vs Spec-Driven Development con Kiro 23.09.2026 52minConstruimos exactamente la misma aplicación dos veces con IA para comparar dos formas distintas de trabajar: primero con Vibe Coding, entregándole directamente la intención al agente, y después usando Specs de Kiro, pasando por requirements.md, design.md y tasks.md antes de implementar. El experimento fue Roomly, una pequeña aplicación para reservar salas. La versión Vibe llegó a una primera versión funcional en unos cinco minutos y resolvió correctamente varios casos, pero permitió crear una reserva en una fecha pasada. Con Specs, Kiro generó requisitos, diseño, arquitectura, tareas y una implementación más estructurada. También apareció el otro lado de la comparación: el proceso tomó bastante más tiempo y consumió muchos más créditos. Al final, la versión basada en Specs sí bloqueó correctamente la reserva en una fecha pasada y cumplió las reglas que probamos. La conclusión no es que un enfoque sea siempre mejor: Vibe Coding puede llevarte mucho más rápido al primer resultado; Specs agrega estructura, trazabilidad y claridad, pero también tiene un costo.
-
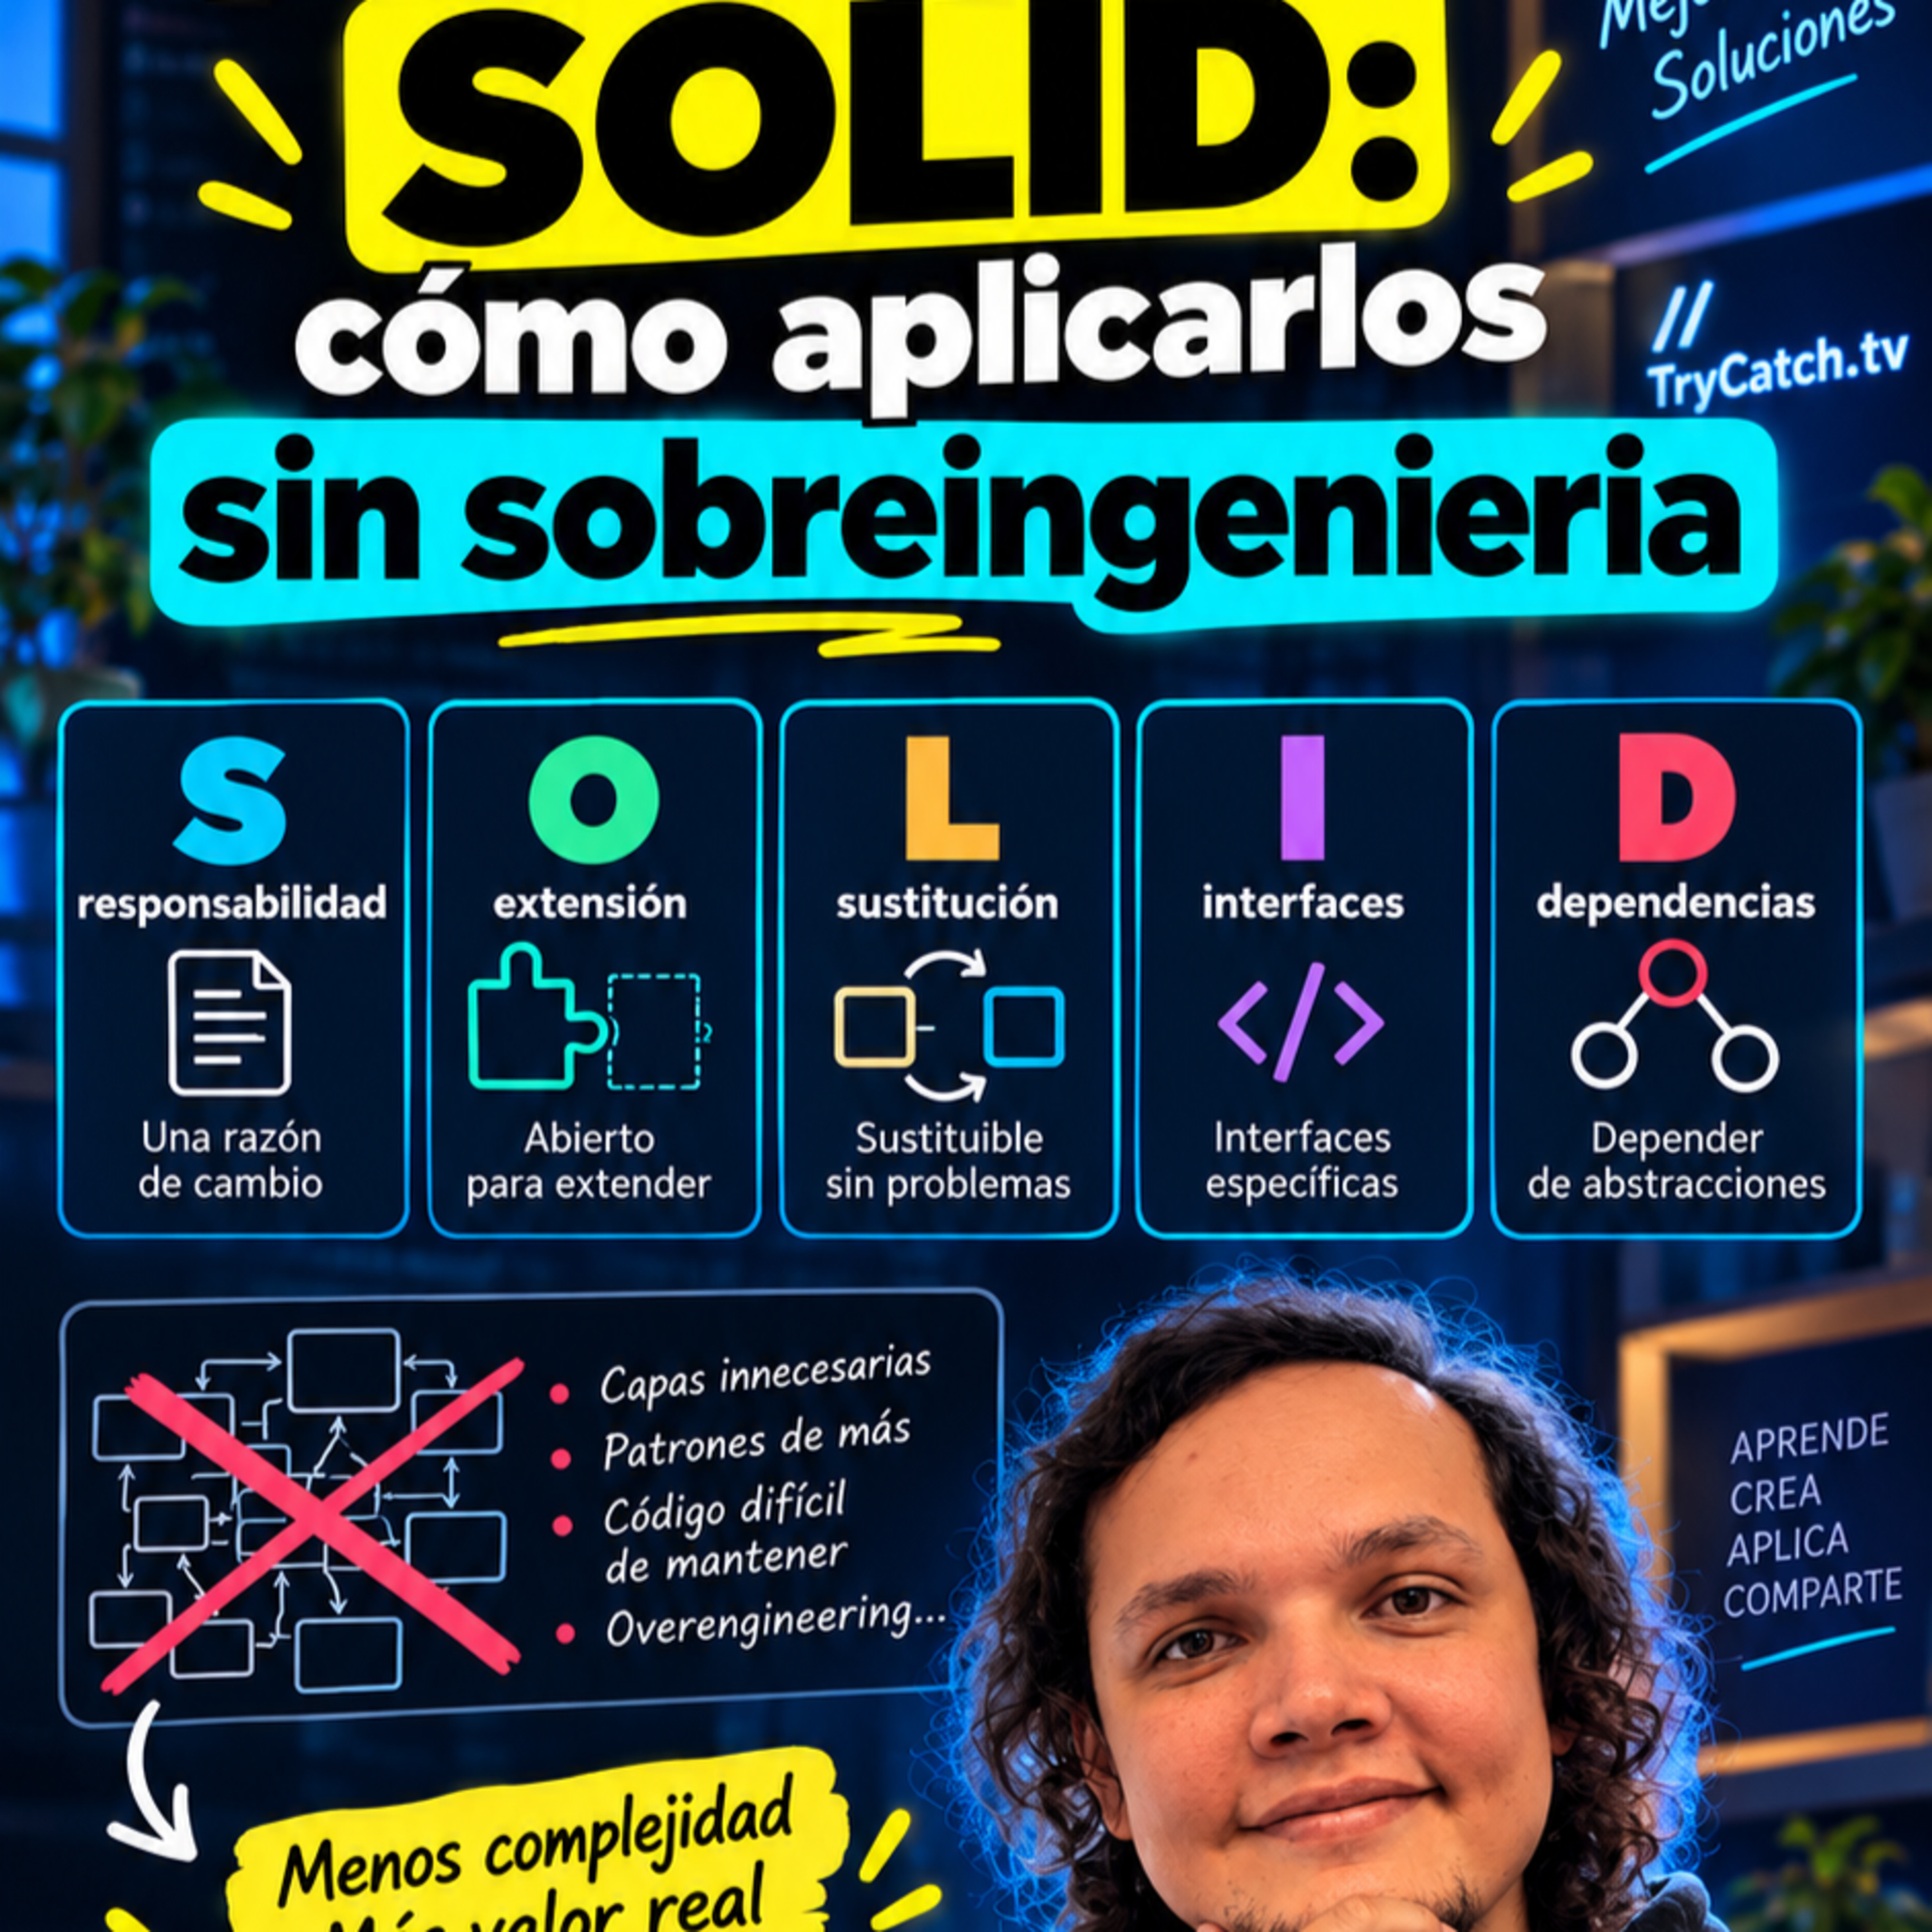 Principios SOLID: cómo aplicarlos sin sobreingeniería 22.09.2026 53minSOLID suele enseñarse como cinco principios que todo buen proyecto debería aplicar, pero seguirlos sin entender el contexto también puede terminar haciendo el código más difícil de mantener.En esta sesión del capítulo 7 de Código Sostenible recorremos responsabilidad única, Open-Closed, sustitución de Liskov, segregación de interfaces e inversión de dependencias, pero desde una mirada práctica: qué problema resuelve cada principio, cuándo aporta valor y cuándo podemos estar agregando complejidad innecesaria.También hablamos de abstracciones, composición frente a herencia, inyección de dependencias y de por qué el criterio y la proporción siguen siendo más importantes que aplicar SOLID como una checklist.La idea central: SOLID no debería hacer que tu código parezca más sofisticado; debería hacer que cambiarlo sea menos peligroso.
-
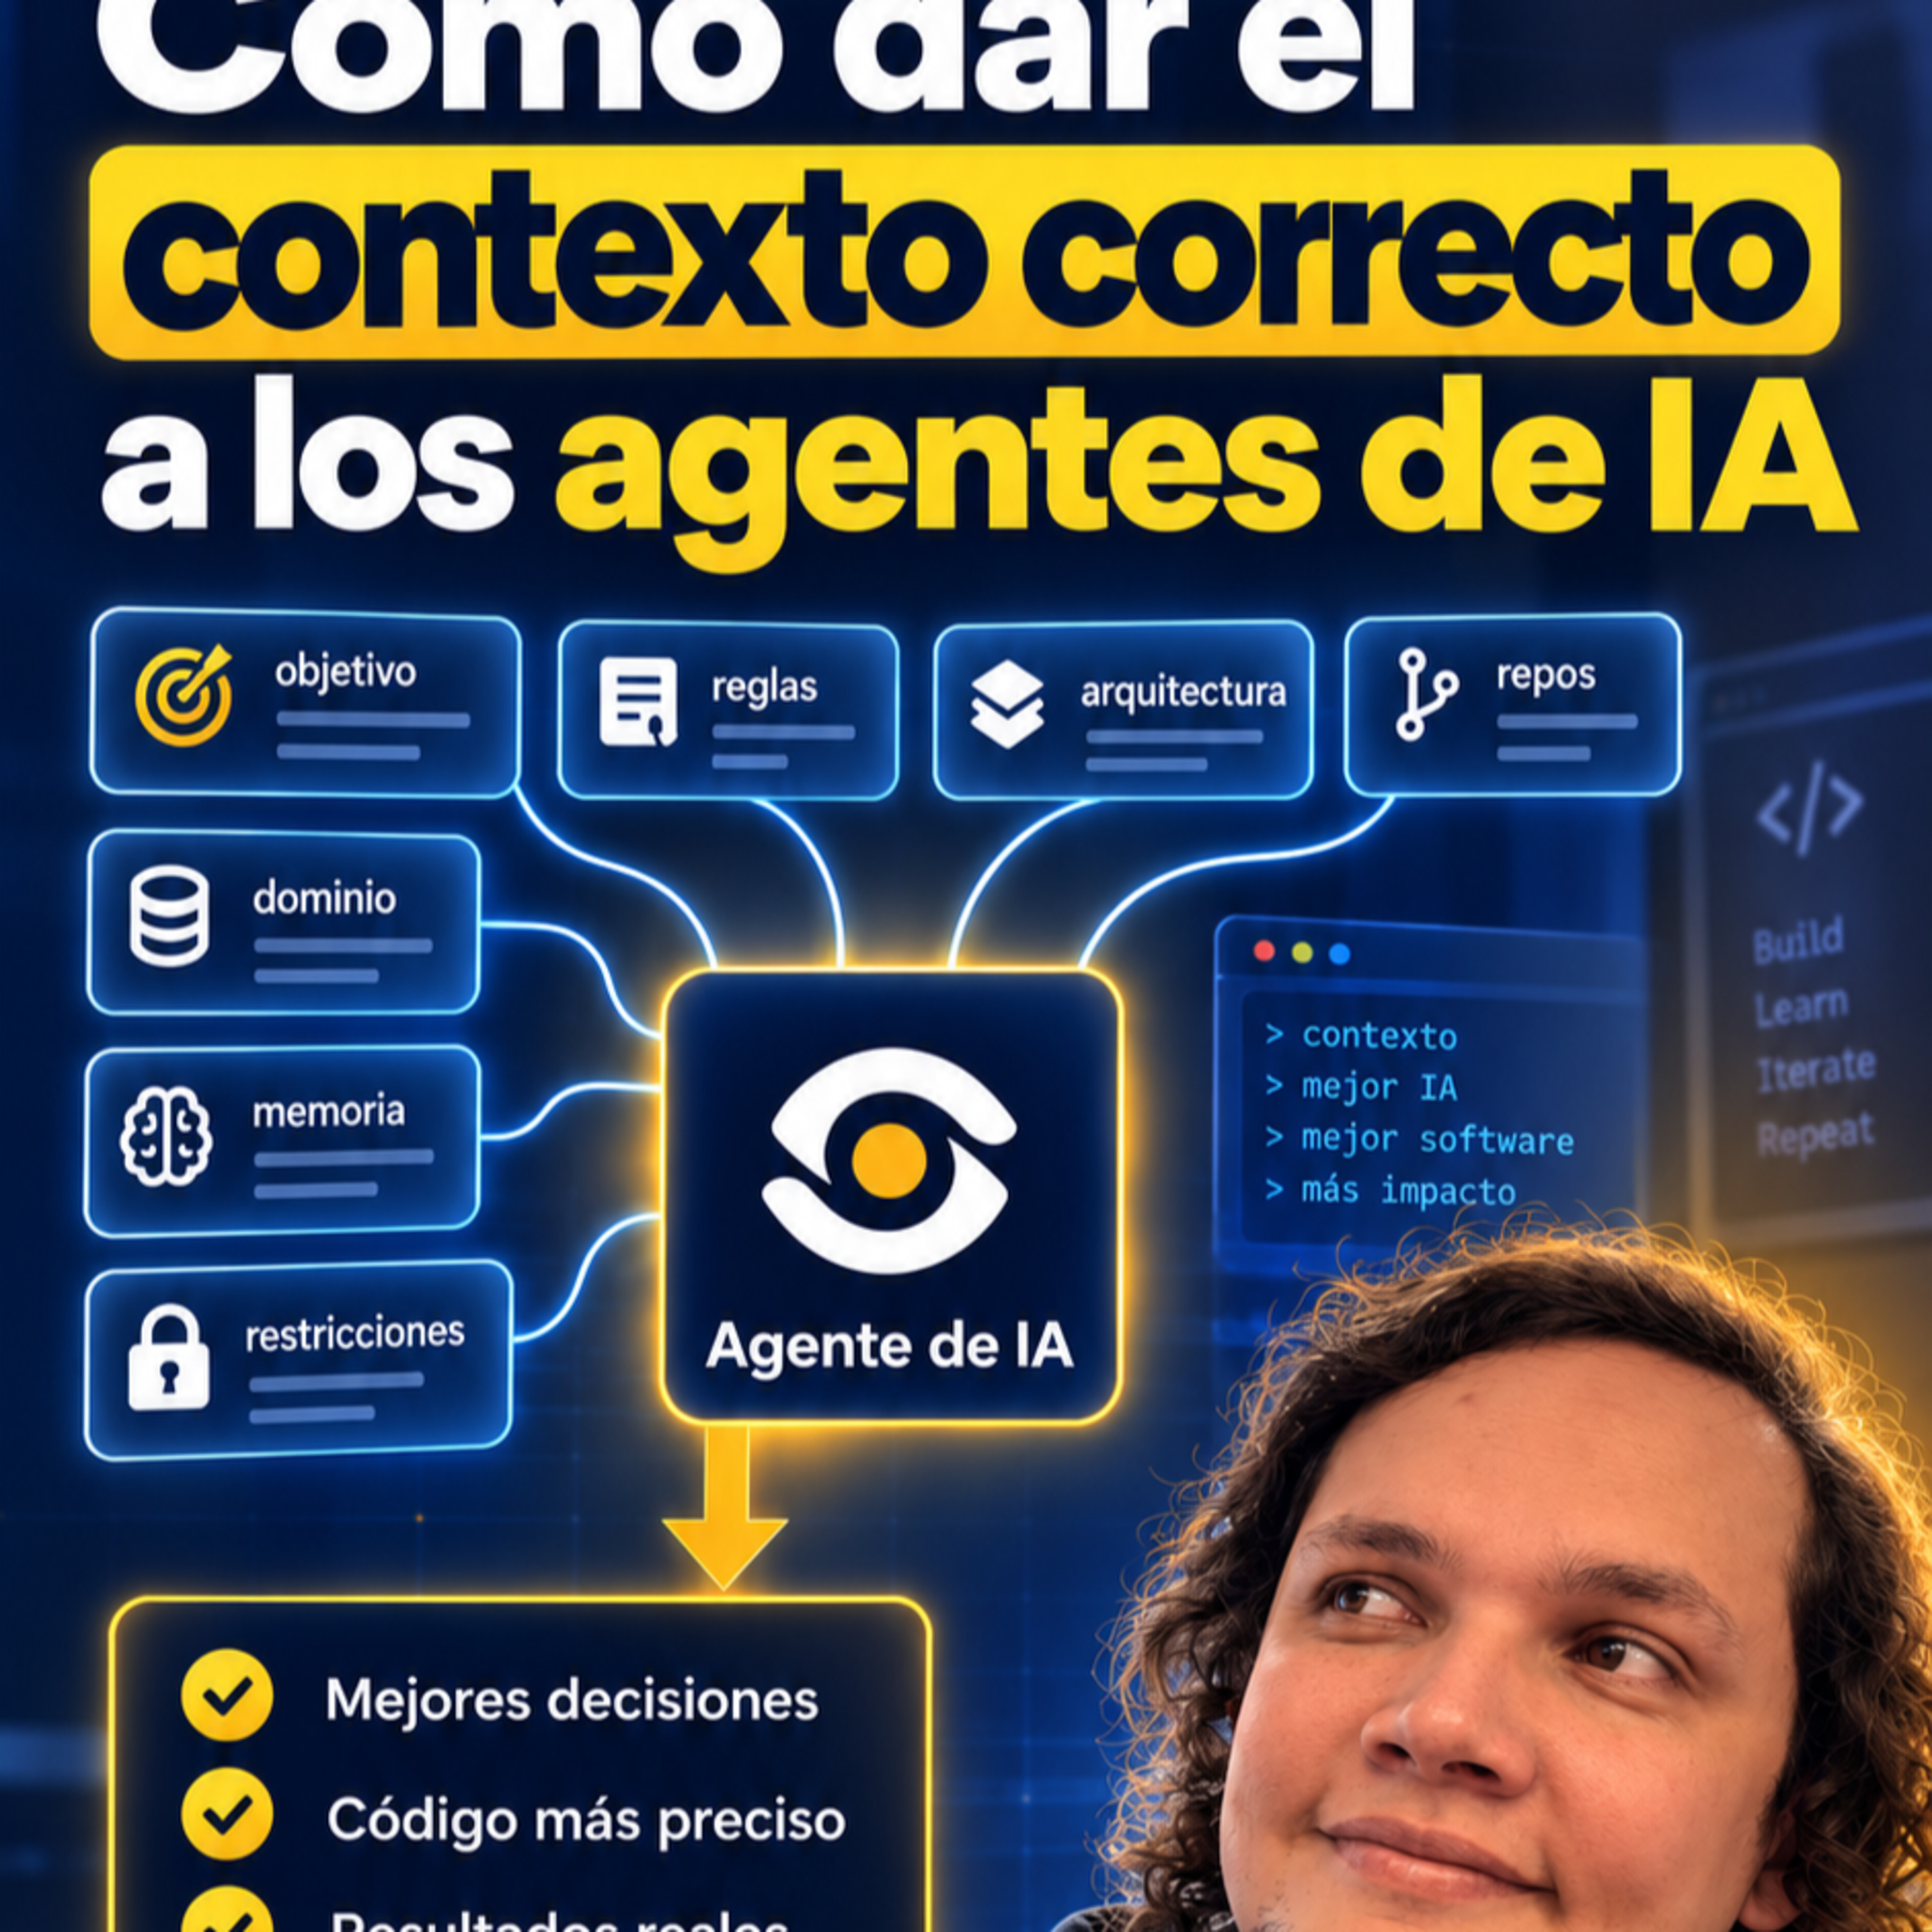 Cómo dar el contexto correcto a los agentes de IA 16.09.2026 57min¿Darle más contexto a un agente de IA siempre produce mejores resultados? No necesariamente.En esta sesión hablamos de cómo el conocimiento que necesita un agente debería crecer según el alcance de la tarea. No requiere lo mismo cambiar el texto de un botón que modificar un flujo completo de registro, donde ya entran APIs, base de datos, reglas de producto y otras partes del sistema.También vemos qué pasa cuando nos vamos al otro extremo y cargamos demasiado contexto, cómo encontrar ese conocimiento mínimo suficiente, qué cambia cuando crecen los equipos y cómo enrutar conocimiento entre módulos y repositorios sin obligar al agente a entender todo el sistema cada vez.Cerramos con un framework práctico para pensar el alcance, componentes, decisiones, riesgos, límites y criterios de aceptación antes de dejar que un agente empiece a construir.
-
 Preguntas reales sobre carrera, IA y futuro del desarrollo de software 12.09.2026 1t 12minEn esta sesión dejamos la escaleta a un lado y respondimos preguntas de la comunidad sobre IA, desarrollo de software, aprendizaje, carrera, mercado laboral, proyectos y emprendimiento.La conversación pasó por cómo podría cambiar el código en un mundo cada vez más agent-native, qué aprovechar realmente de la universidad, cómo usar roadmaps sin intentar aprenderlo todo, qué está pidiendo hoy el mercado y por qué algunas vacantes empiezan a mezclar desarrollo, producto, negocio y comunicación en un mismo rol. También hablamos de proyectos personales, habilidades para vender lo que construimos, preparación para entrevistas, búsqueda de trabajo y hasta herramientas que ya están usando agentes para automatizar postulaciones. La idea que terminó conectando casi toda la sesión fue sencilla: las herramientas cambian muy rápido, pero criterio, fundamentos, comunicación y capacidad para resolver problemas siguen siendo cada vez más importantes.
-
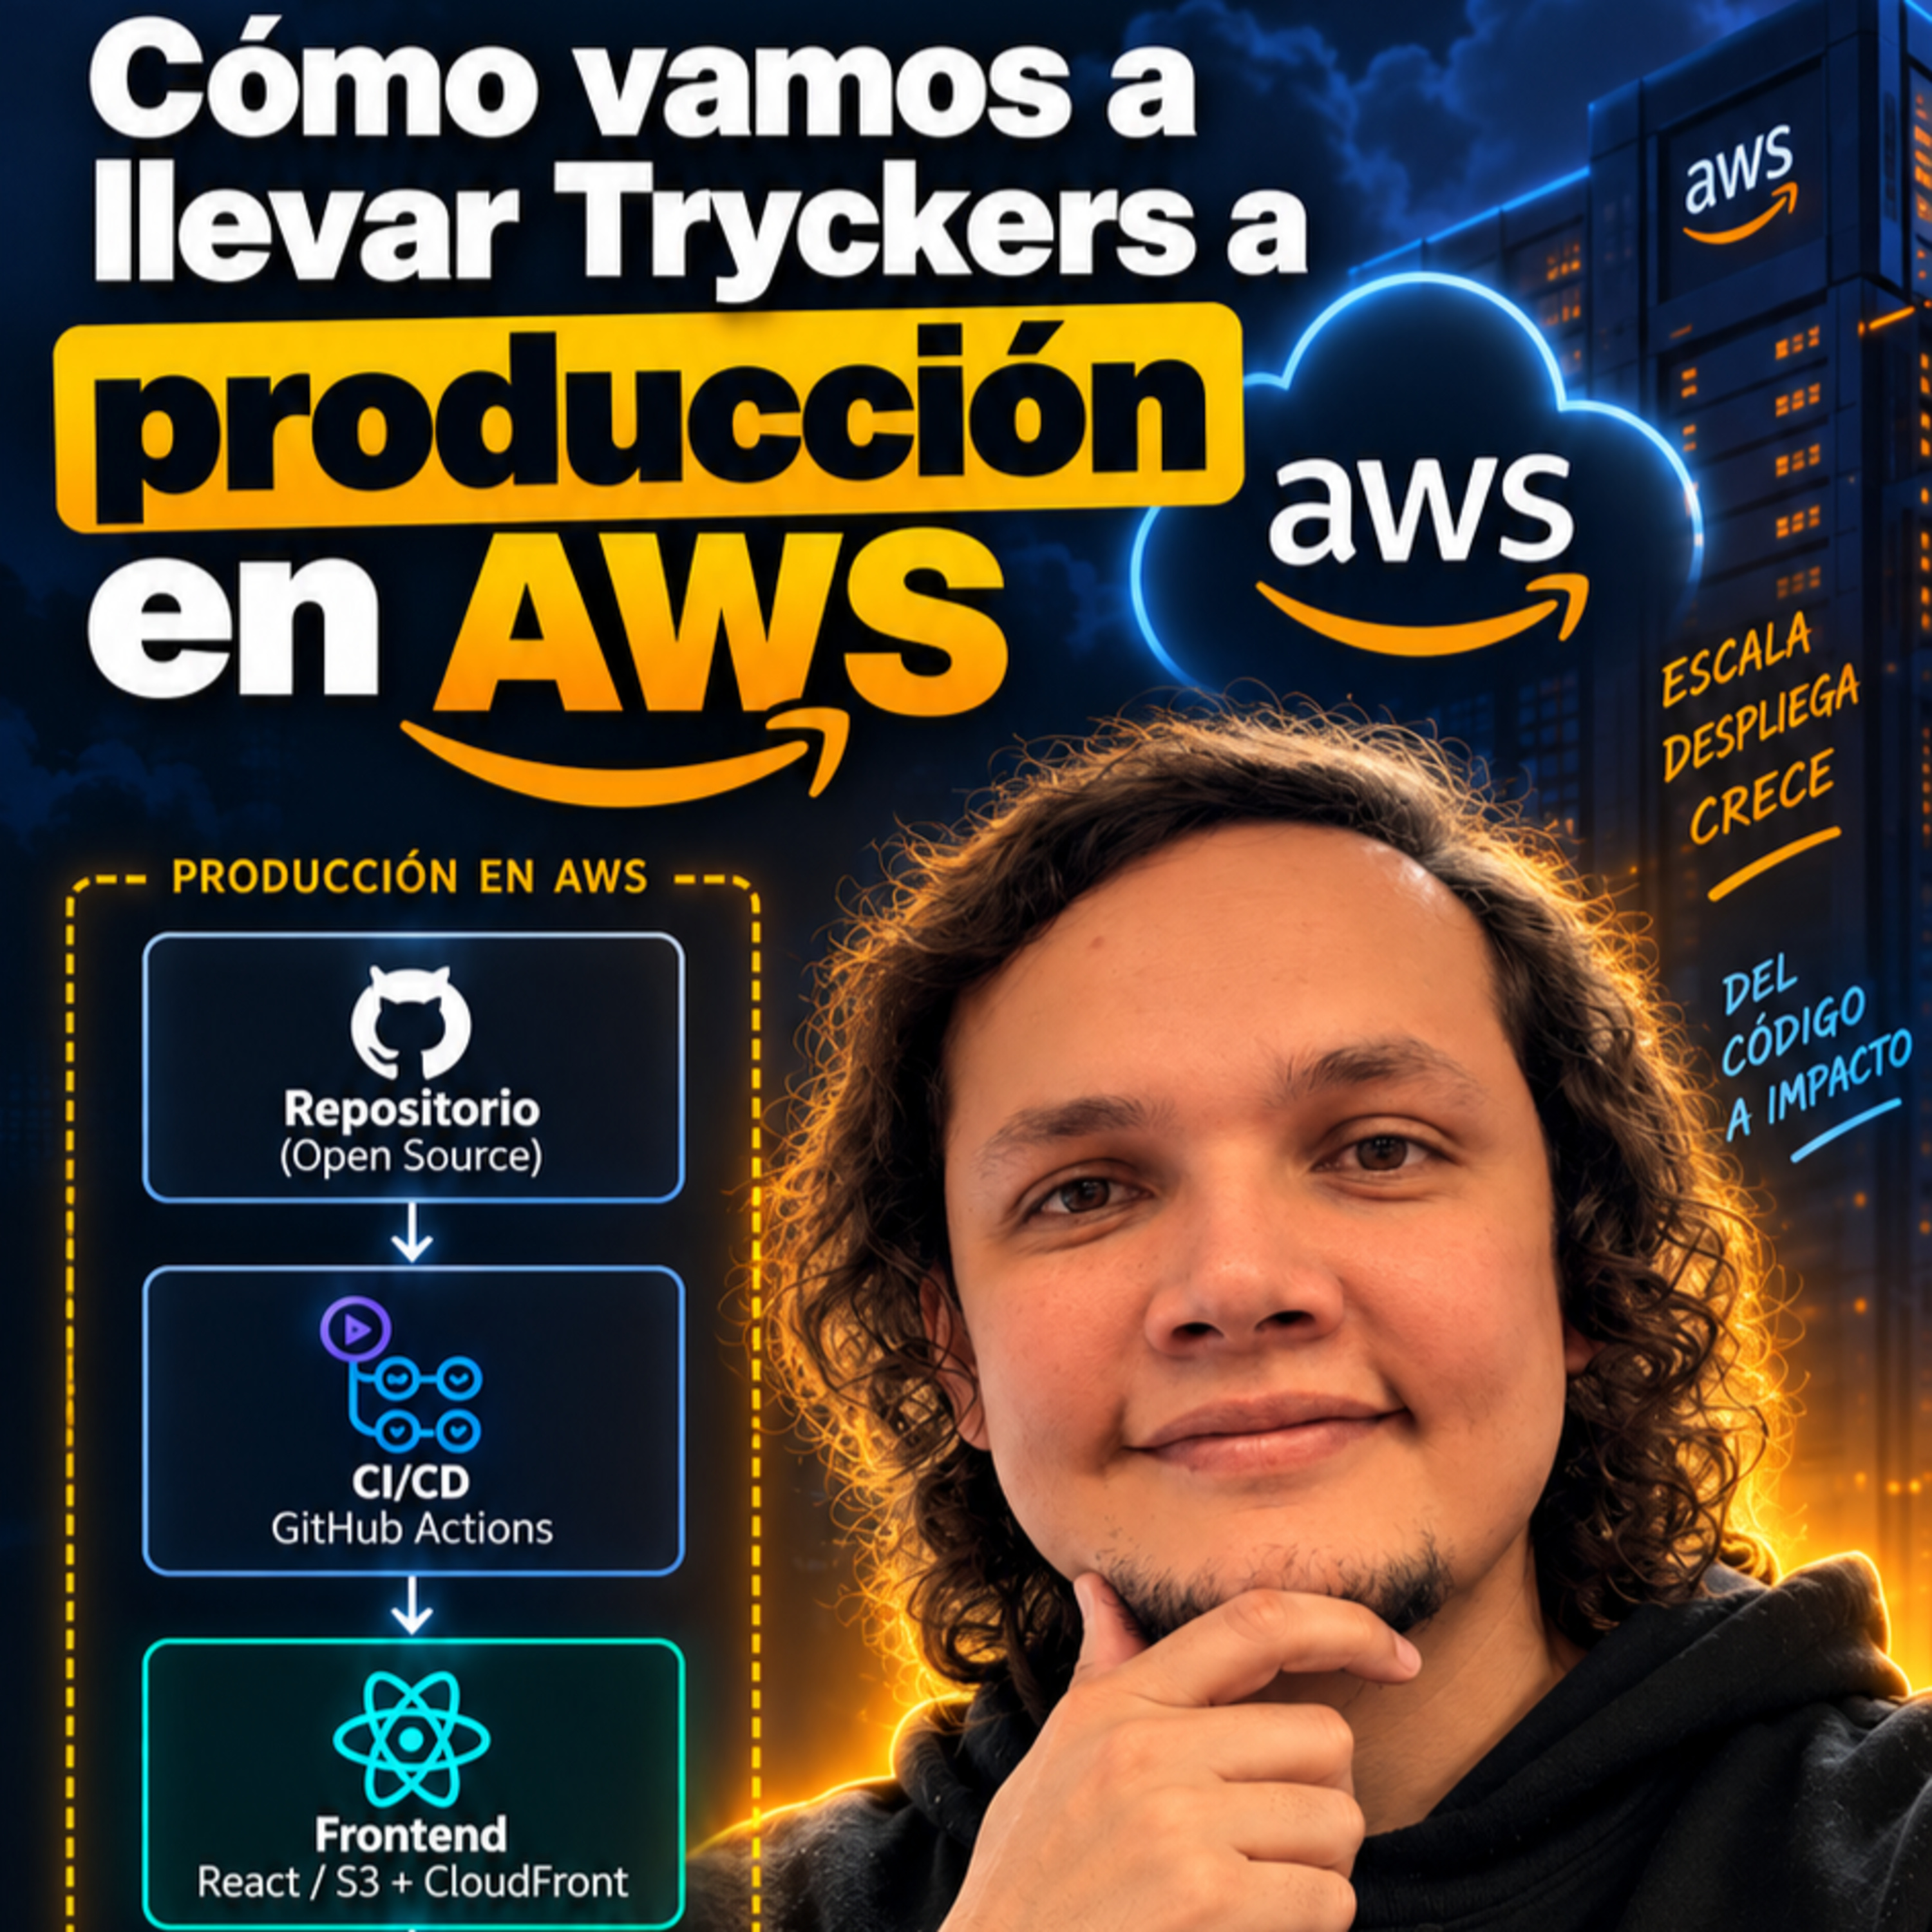 Cómo vamos a llevar Tryckers a producción en AWS 11.09.2026 1t 7minRetomamos Tryckers, el directorio open source de la comunidad, para revisar en qué estado está el MVP y definir qué necesitamos para llevarlo a producción.Durante la sesión evaluamos distintas opciones de infraestructura en AWS para el frontend, backend y base de datos, teniendo en cuenta algo clave: queremos aprender haciendo, pero sin sobrearquitectar ni gastar créditos innecesariamente.Comparamos alternativas como Amplify, S3 + CloudFront, EC2 + Docker, ECS/Fargate y RDS PostgreSQL, y terminamos definiendo una primera arquitectura que pueda evolucionar con el proyecto.La idea central: no se trata de usar más servicios de AWS, sino de escoger los suficientes para aprender, desplegar y poder evolucionar después.
-
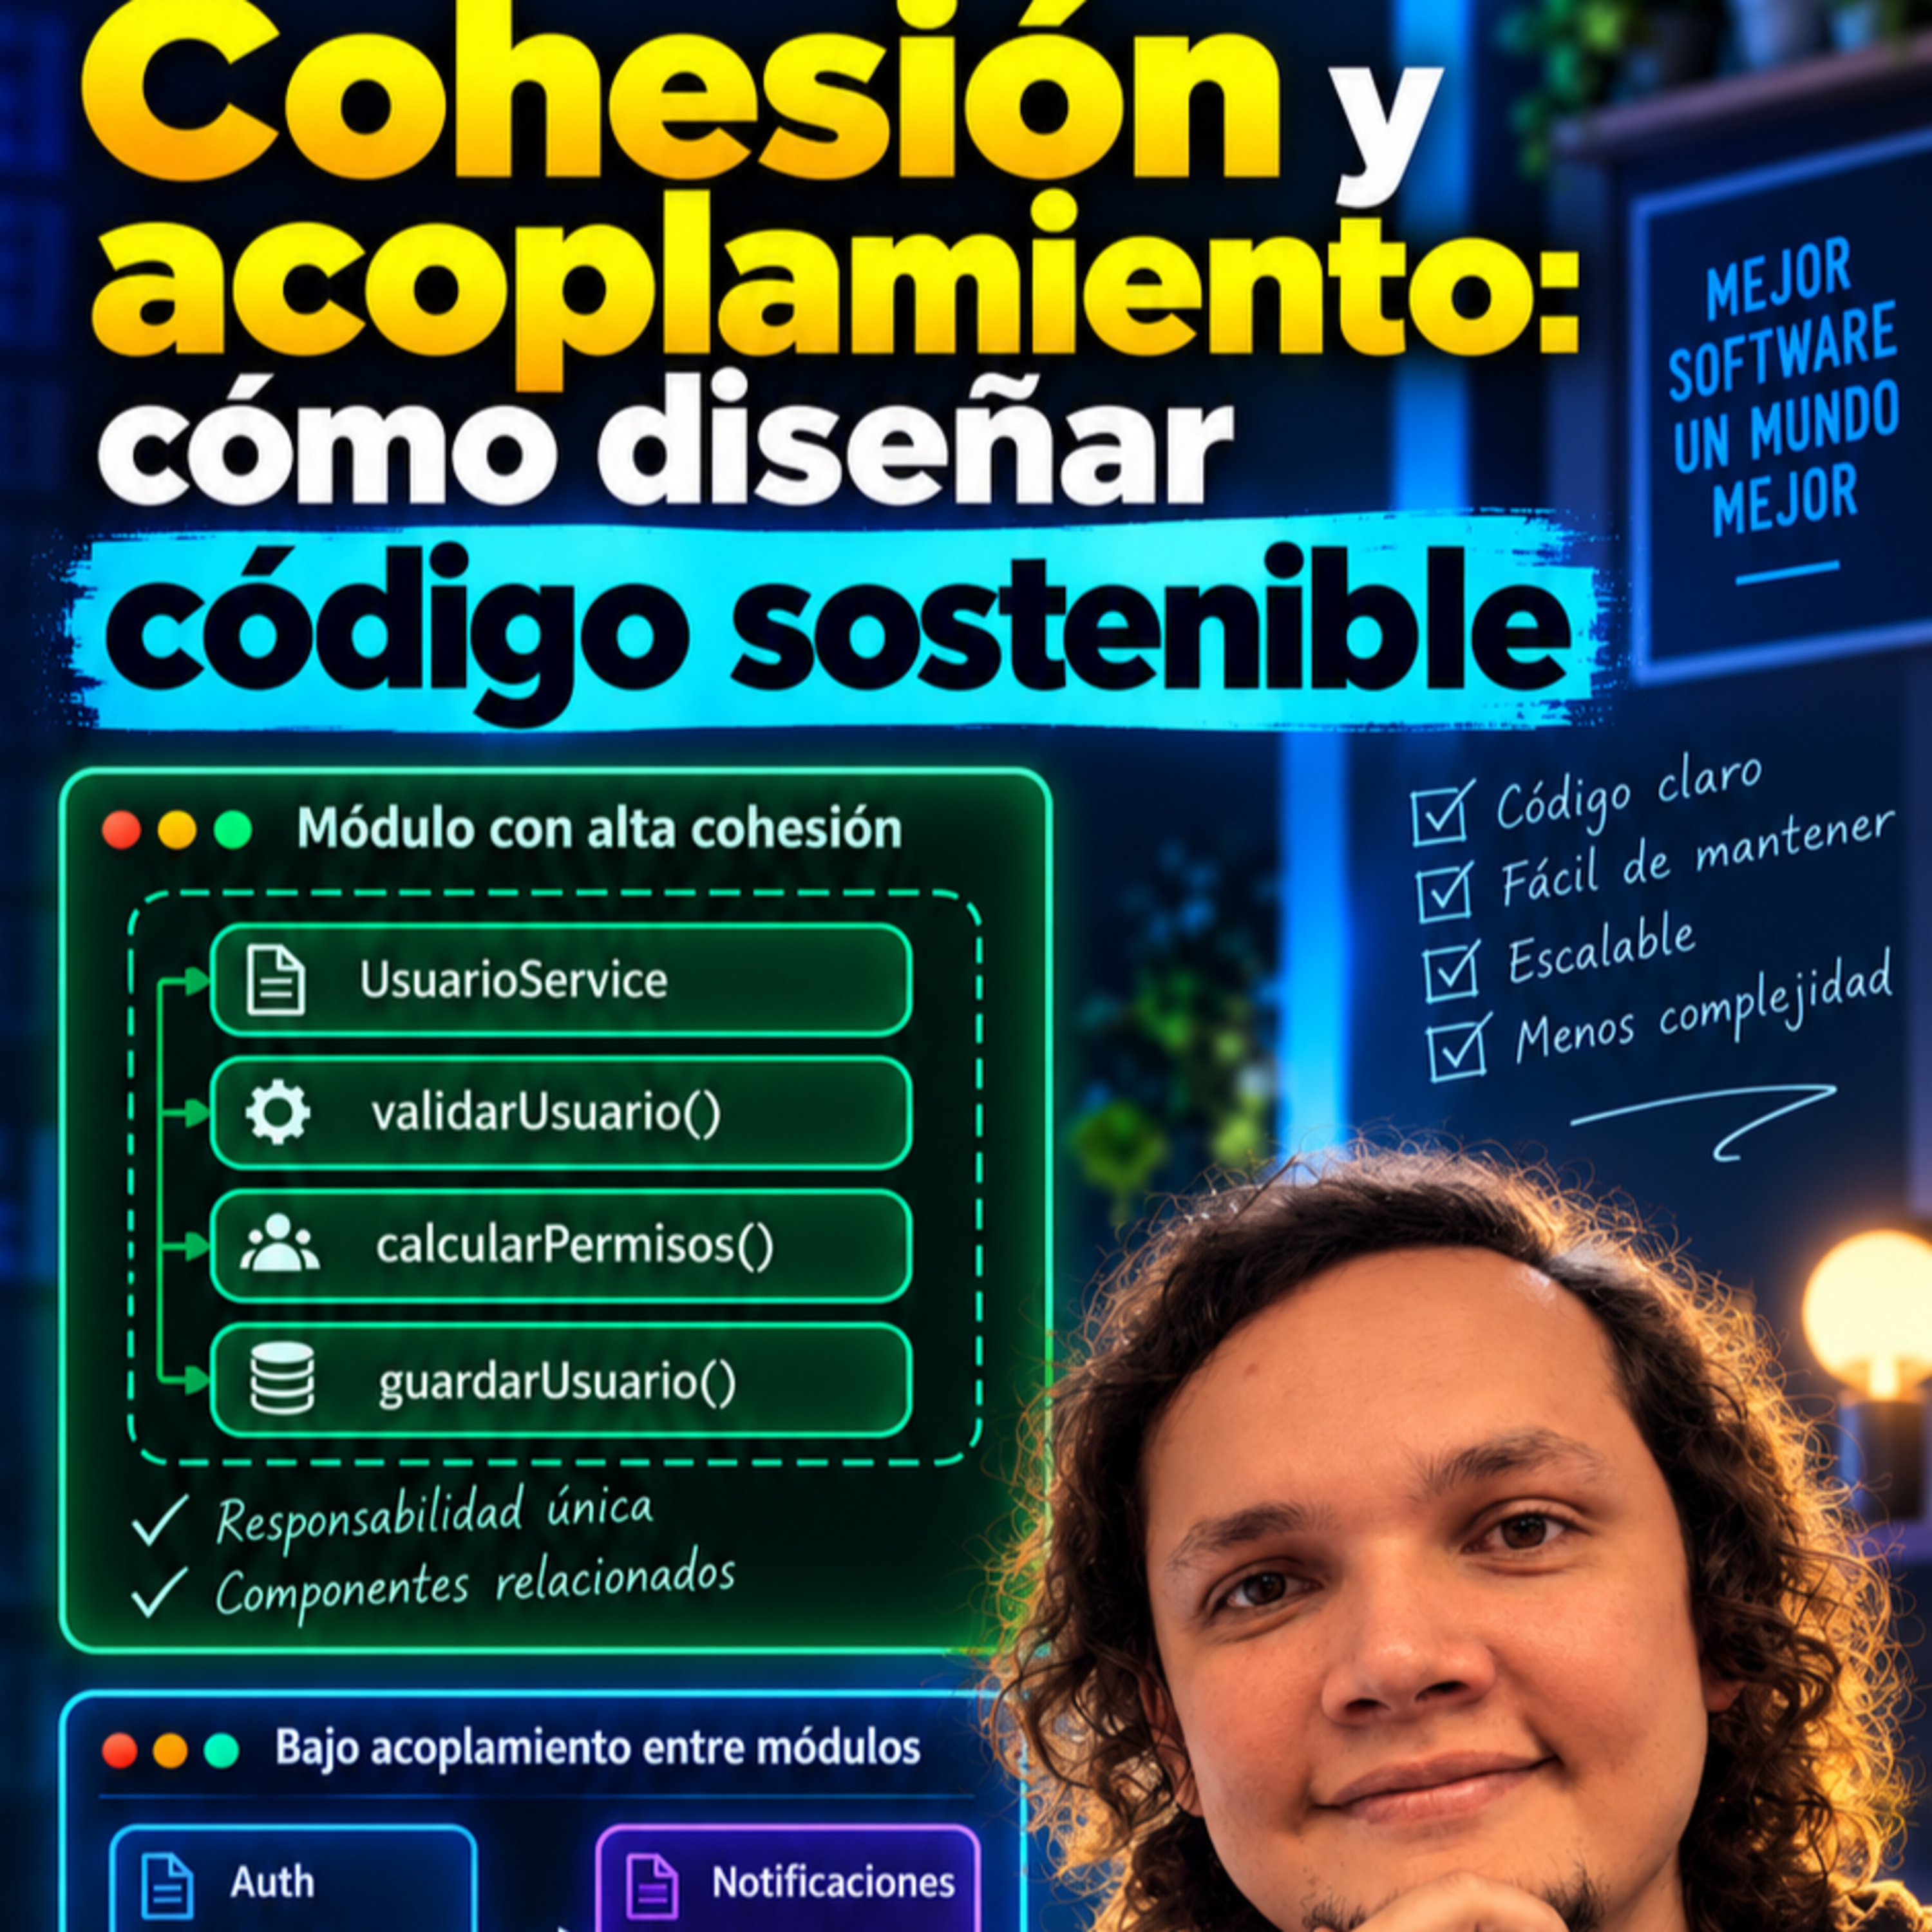 Cohesión y acoplamiento: cómo diseñar código sostenible 10.09.2026 53minEn este episodio seguimos con la lectura de Código Sostenible, capítulo 6: Cohesión y acoplamiento.Hablamos de por qué estos dos conceptos funcionan como una brújula para tomar mejores decisiones de diseño: mantener juntas las cosas que realmente pertenecen juntas y reducir las dependencias innecesarias entre componentes.También recorremos ortogonalidad, dependencias cíclicas, inyección de dependencias, arquitectura hexagonal, Ley de Demeter, Tell, don’t ask y connascence para entender una pregunta fundamental: si cambio una parte del sistema, ¿cuántas otras estoy obligando a cambiar conmigo?La idea central: el código sostenible no elimina las dependencias; evita que cada dependencia termine convirtiéndose en una cadena difícil de romper.
-
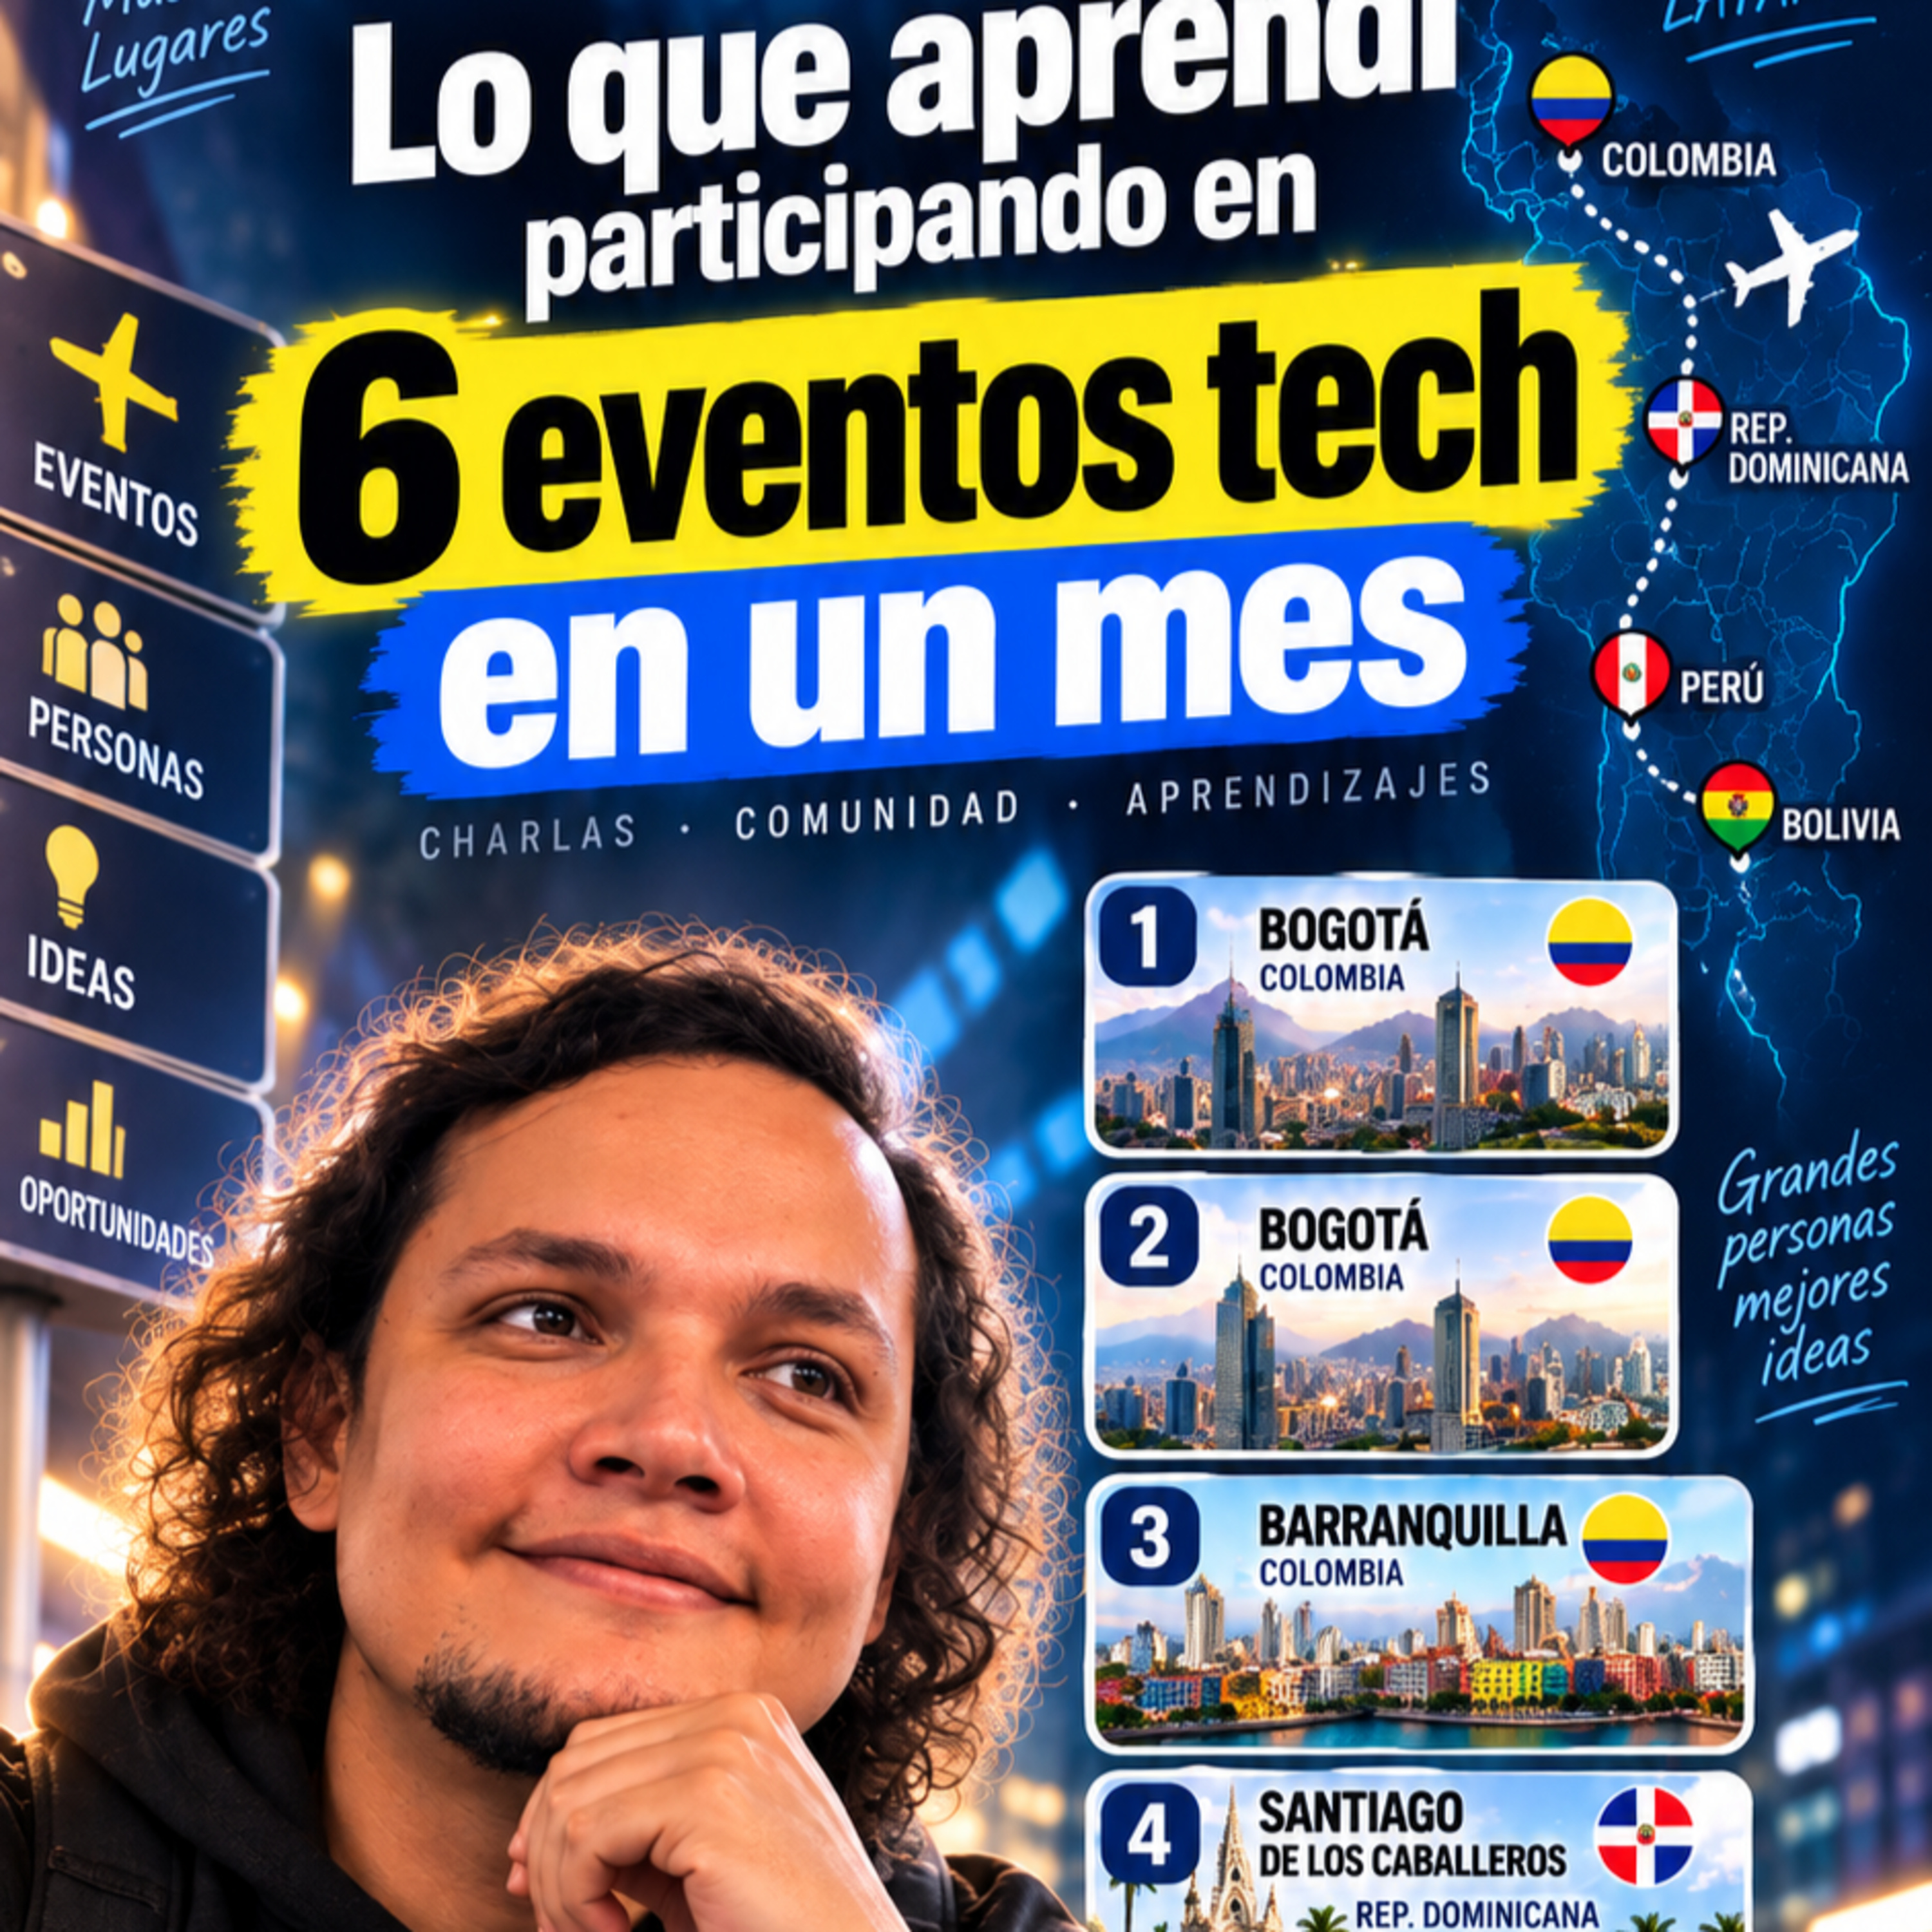 Lo que aprendí participando en 6 eventos tech en un mes 09.09.2026 1t 11minDurante casi un mes estuve mucho menos presente en las transmisiones de TryCatch.tv, pero fue porque la comunidad salió de la pantalla.Pasé por AWS Summit Bogotá, Latam Architecture Day, CaribeDev Barranquilla, Containers Day en República Dominicana, DevOps Day Lima y AWS Community Day Bolivia. En este episodio cuento cómo fue vivir esos eventos, viajar entre ciudades y países, participar como speaker y encontrarme cara a cara con personas que durante años solo había conocido por un username.Más allá de las charlas, quedaron conversaciones, comunidad, cansancio, aprendizajes y una confirmación importante: crear contenido y compartir conocimiento durante años termina abriendo puertas que muchas veces uno ni siquiera sabía que existían.La idea central: los eventos no valen solamente por lo que ocurre en el escenario, sino por las personas y conexiones que aparecen alrededor.
-
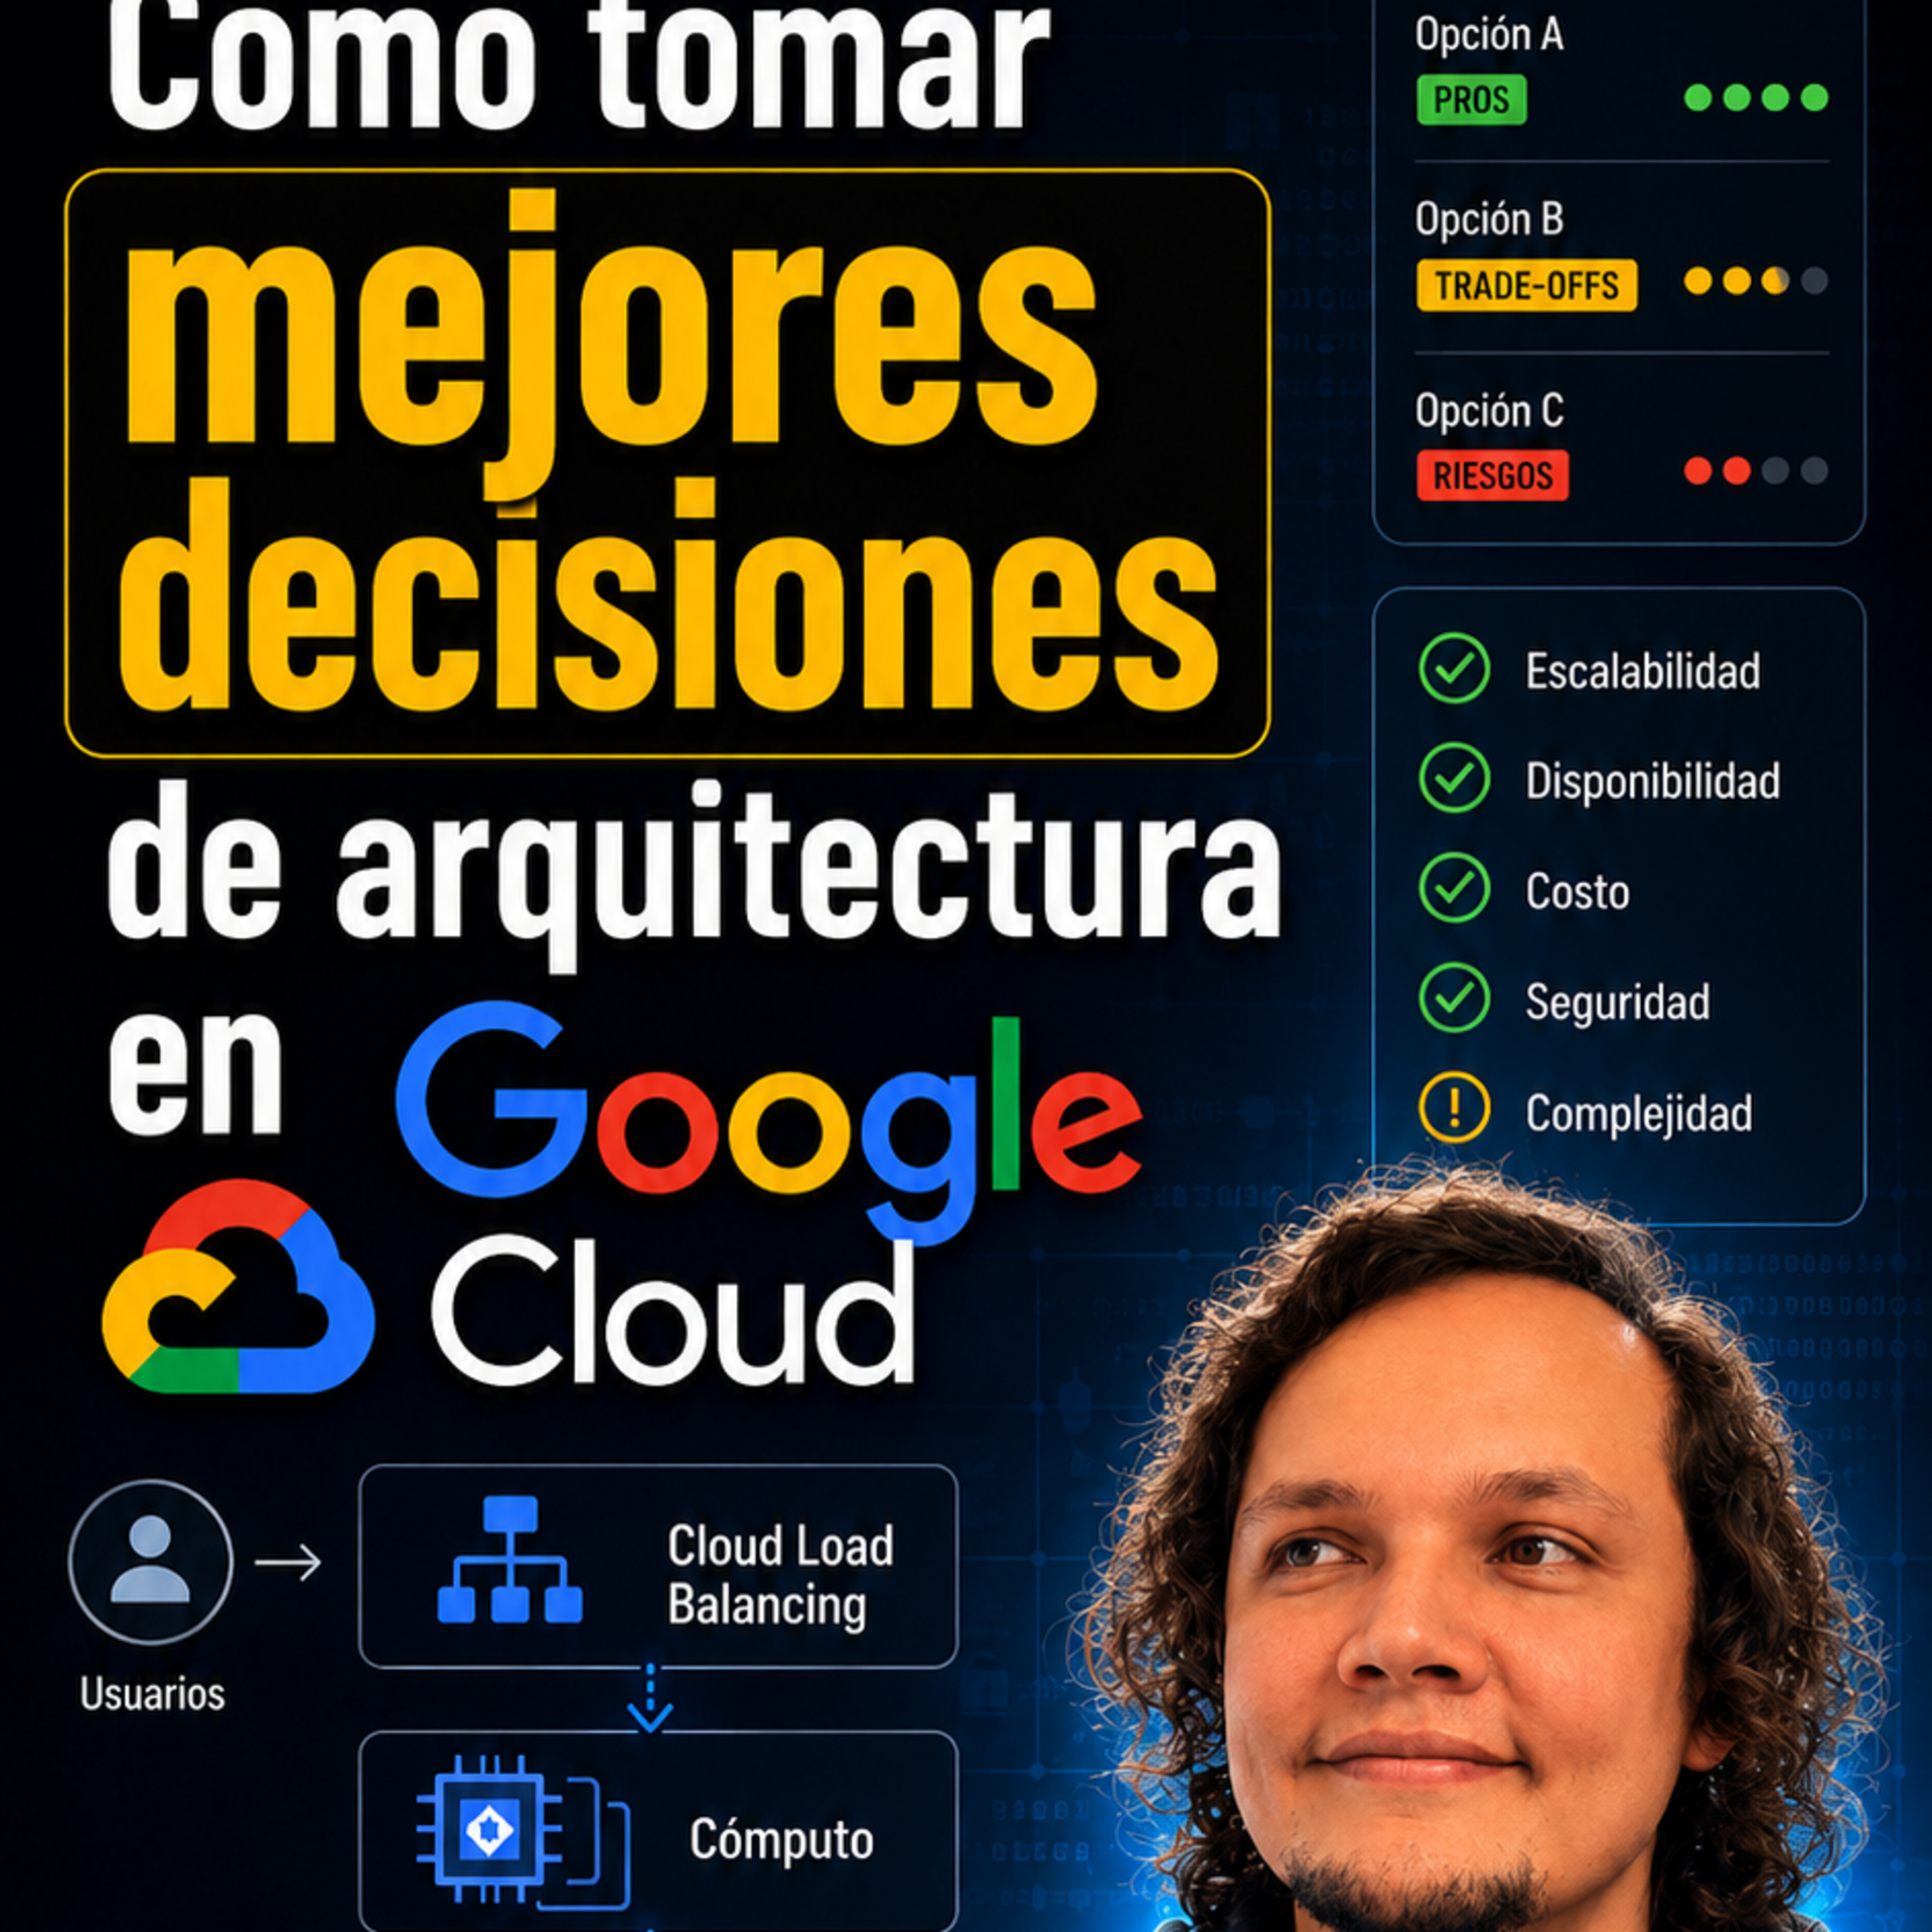 Cómo tomar mejores decisiones de arquitectura en Google Cloud 19.08.2026 55minEn este episodio hablamos de trade-offs reales en Google Cloud a partir de tres decisiones muy comunes: Cloud SQL vs Firestore, Cloud Run vs GKE y HTTP vs Pub/Sub.La idea no es decidir qué servicio es “mejor”, sino entender qué problema estamos resolviendo, qué atributo de calidad importa, qué complejidad introducimos y qué costo operativo estamos dispuestos a asumir.También hablamos de escala futura, sobrearquitectura, costo humano de la infraestructura, acoplamiento, asincronía, observabilidad e idempotencia.La conclusión: una buena decisión de arquitectura no elige la tecnología más poderosa, sino la que mejor encaja con el contexto actual y puede evolucionar cuando ese contexto cambie.
Lignende podkaster


Populær i
Denne podkasten finnes også i podkast-listene til disse landene.
